La réponse courte
- Gardez Opus 5.5 par défaut pour le code au quotidien, la rédaction, les agents terminal et DevOps, et les pipelines à gros volume. Anthropic le présente lui-même comme son "strongest daily driver".
- Passez à Fable 5.2 pour les longues sessions d'agent, les migrations difficiles, la recherche sur graphiques et documents, la CAO et la 3D, la robotique, les sciences, et toute tâche qu'Opus 5.5 a ratée deux fois.
- Comparez à effort égal, pas à effort par défaut. Dans l'API, Fable 5.2 est réglé sur
highpar défaut et Opus 5.5 surmedium. Sans rien régler, une tâche Fable coûte 3,7x plus cher, et l'essentiel de cet écart vient du niveau d'effort, pas du modèle.
Fable 5.2 vs Opus 5.5 : caractéristiques et tarifs
| Claude Fable 5.2 | Claude Opus 5.5 | |
|---|---|---|
| Date de sortie | 9 novembre 2026 | 22 septembre 2026 |
| Identifiant API | claude-fable-5-2 |
claude-opus-5-5 |
| Prix entrée / sortie | 8 $ / 40 $ par million de tokens | 4 $ / 20 $ par million de tokens |
| Lecture / écriture du cache | 0,20 $ / 10 $ par million de tokens | 0,20 $ / 5 $ par million de tokens |
| Fast mode (jusqu'à 2,5x plus rapide en sortie) | 16 $ / 80 $ par million de tokens | 8 $ / 40 $ par million de tokens |
| Fenêtre de contexte / sortie max | 1M / 128K tokens | 1M / 128K tokens |
| Raisonnement | Adaptatif, toujours actif | Adaptatif, toujours actif |
| Effort par défaut (API) | high | medium |
| Vitesse de sortie (Artificial Analysis) | 87 à 103 tokens/s | 103 à 115 tokens/s |
| Conservation des données | Rétention de 30 jours obligatoire, pas de zero data retention sauf autorisation d'Anthropic | Standard |
Fable 5.2 remplace aussi Fable 5.1 à un prix plus bas (8 $ / 40 $ contre 10 $ / 50 $) et, selon Anthropic, génère sa réponse jusqu'à 30 % plus vite que Fable 5.1. Opus 5.5 produit toujours ses tokens plus vite, mais cela compte moins qu'il n'y paraît : à intelligence égale, Fable 5.2 termine souvent la tâche avant lui parce qu'il a besoin de moins d'étapes. Les détails sont dans la partie sur les coûts.
Benchmarks Fable 5.2 vs Opus 5.5 : le tableau complet
Trois sources réunies dans un seul tableau. Les chiffres de lancement d'Anthropic utilisent l'effort le plus élevé disponible pour chaque modèle. BenchLM agrège les résultats publiés. Artificial Analysis (AA) fait tourner ses propres évaluations, et nous reprenons ici ses lignes en effort max. Les victoires d'Opus 5.5 sont en gras.
| Benchmark | Ce qu'il mesure | Fable 5.2 | Opus 5.5 | Écart | Source |
|---|---|---|---|---|---|
| FrontierCode 2.0 | Code agentique | 49,1 % | 45,5 % | +3,6 Fable | Anthropic |
| FrontierSWE v2 | Code agentique | 69,9 % | 62,3 % | +7,6 Fable | Anthropic |
| SWE-bench Pro | Corrections sur de vrais dépôts | 93,0 % | 89,9 % | +3,1 Fable | BenchLM |
| SWE Multimodal | Corrections à partir de captures / UI | 74,1 % | 61,4 % | +12,7 Fable | BenchLM |
| CursorBench 4.0 | Tâches de code dans l'IDE | 60,0 % | 57,8 % | +2,2 Fable | BenchLM |
| Terminal-Bench 4.0 | Agents shell / DevOps | 67,6 % | 66,4 % | +1,2 Fable | BenchLM |
| ProgramBench | Synthèse de programmes | 85,6 % | 91,2 % | +5,6 Opus | BenchLM |
| AutomationBench | Workflows métier | 51,4 % | 42,5 % | +8,9 Fable | Anthropic |
| Terminal-Bench-Science 0.1 | Science agentique | 74,6 % | 58,7 % | +15,9 Fable | Anthropic |
| WANDR (relaxed) | Recherche web agentique | 82,1 % | 72,3 % | +9,8 Fable | Anthropic |
| OSWorld 2.1 (offline) | Pilotage d'ordinateur | 89,3 % | 87,2 % | +2,1 Fable | Anthropic |
| RoboDojo Sim | Robotique | 64,9 % | 39,4 % | +25,5 Fable | Anthropic |
| Remote Labor Index | Missions type freelance rémunérées | 41,3 % | 21,3 % | +20,0 Fable | Anthropic |
| Humanity's Last Exam (outils) | Questions niveau expert | 74,2 % | 67,7 % | +6,5 Fable | Anthropic |
| Chartography (sans outils) | Lecture de graphiques | 73,4 % | 64,4 % | +9,0 Fable | Anthropic |
| BenchCAD 2.1 (outils) | Modélisation CAO | 83,5 % | 65,3 % | +18,2 Fable | Anthropic |
| BenchCAD 2.1 (sans outils) | Modélisation CAO | 75,4 % | 49,0 % | +26,4 Fable | BenchLM |
| AA-Briefcase v1.1 (grille) | Livrables de travail intellectuel | 66,1 % | 61,2 % | +4,9 Fable | Anthropic |
| AA-Briefcase v1.1 (Elo) | Préférence en face-à-face | 1785 | 1800 | +15 Opus | Anthropic |
| PhysicianBench | Raisonnement clinique | 64,4 % | 68,4 % | +4,0 Opus | BenchLM |
| GMMLU | Connaissances multilingues | 96,0 % | 94,3 % | +1,7 Fable | BenchLM |
| Intelligence Index (max) | Score composite AA | 65 | 59 | +6 Fable | AA |
| AA-Omniscience v1.1 (max) | Connaissances sans hallucination | 67 | 48 | +19 Fable | AA |
| GDP.pdf (max) | Tâches sur documents | 24,2 % | 26,2 % | +2,0 Opus | AA |
Bilan : 20 lignes pour Fable 5.2, 4 pour Opus 5.5. Derrière le score global, trois tendances comptent davantage :
- L'écart est faible sur le code et énorme ailleurs. Sur les benchmarks de code textuels, Fable mène de 1 à 8 points, et Opus gagne ProgramBench. Les gros écarts (+16 à +26 points) concernent la robotique, la CAO, les sciences et les longues missions de type freelance. Si vous faites surtout du code, Fable 5.2 est un gain plus modeste que ne le laisse penser sa moyenne.
- Terminal-Bench 4.0, c'est quasiment l'égalité. 67,6 % contre 66,4 % sur BenchLM, et 59,6 % des deux côtés en effort max chez Artificial Analysis. Les agents qui vivent dans le shell (CI, infra, déploiements) ne gagnent presque rien avec Fable.
- Fable 5.2 hallucine moins, même en effort low. Sur AA-Omniscience, Fable en effort low obtient 63, Opus en effort max obtient 48. Réfléchir plus longtemps ne compense pas une connaissance absente. Cognition l'a résumé au lancement : "Claude Fable 5.2 says it doesn't know things instead of hallucinating."
Une ligne mérite un second regard : AA-Briefcase. Fable 5.2 valide plus de critères de la grille (66,1 % contre 61,2 %), mais en comparaison directe, les évaluateurs préfèrent légèrement les livrables d'Opus 5.5 (Elo 1800 contre 1785). Nous y voyons une différence de présentation, pas de justesse. C'est aussi ce que beaucoup de développeurs disaient à la sortie de Fable 5.1 : le style d'écriture d'Opus plaît davantage.
Coût par tâche : pourquoi 2x le prix ne fait pas 2x la facture
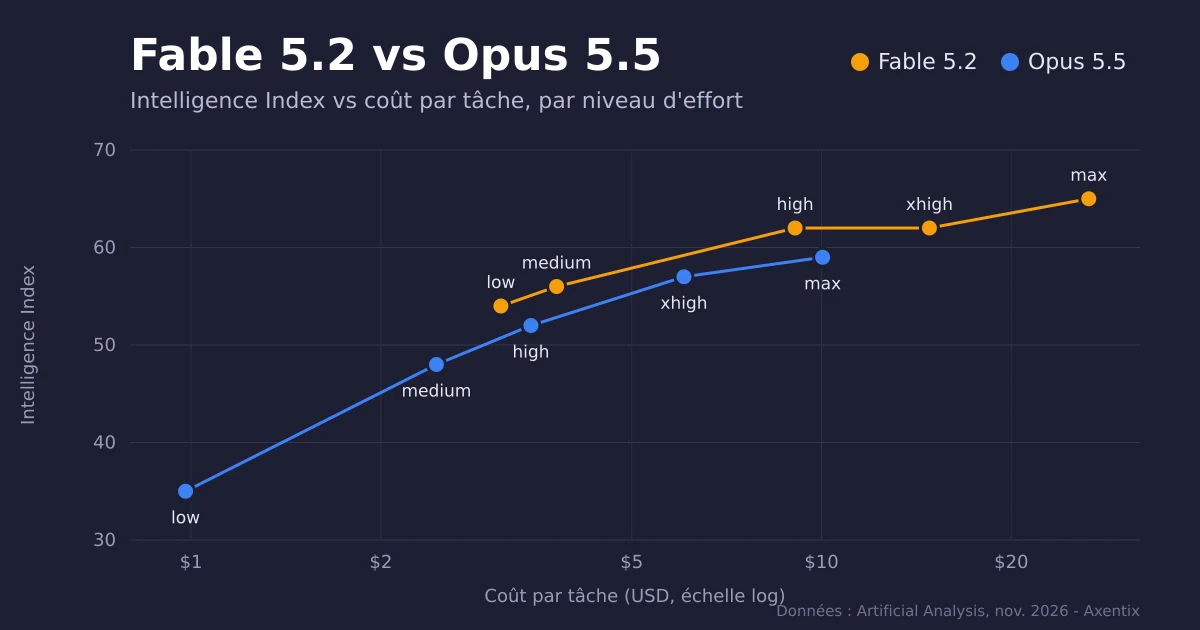
Le prix au token et le coût d'une tâche terminée sont deux chiffres différents. Artificial Analysis publie les deux pour chaque niveau d'effort. Voici les dix configurations, triées par coût par tâche :
| Modèle (effort) | Coût par tâche | Intelligence Index | Temps par tâche | Délai avant le premier token |
|---|---|---|---|---|
| Opus 5.5 (low) | 0,98 $ | 35 | 3,0 min | 5,0 s |
| Opus 5.5 (medium) | 2,45 $ | 48 | 7,1 min | 13,3 s |
| Fable 5.2 (low) | 3,10 $ | 54 | 6,5 min | 6,4 s |
| Opus 5.5 (high) | 3,46 $ | 52 | 9,5 min | 25,4 s |
| Fable 5.2 (medium) | 3,80 $ | 56 | 8,3 min | 12,6 s |
| Opus 5.5 (xhigh) | 6,05 $ | 57 | 16,2 min | 76,4 s |
| Fable 5.2 (high) | 9,08 $ | 62 | 17,4 min | 30,5 s |
| Opus 5.5 (max) | 10,04 $ | 59 | 25,1 min | 372,1 s |
| Fable 5.2 (xhigh) | 14,83 $ | 62 | 26,3 min | 74,6 s |
| Fable 5.2 (max) | 26,54 $ | 65 | 44,6 min | 221,2 s |
Lisez-le par paires de budget comparable, et la conclusion change :
- Fable low contre Opus high : 3,10 $ contre 3,46 $, 54 contre 52, 6,5 contre 9,5 minutes. Fable est moins cher, plus intelligent et 30 % plus rapide.
- Fable medium contre Opus xhigh : 3,80 $ contre 6,05 $ pour un score quasi identique (56 contre 57), en deux fois moins de temps.
- Fable high contre Opus max : 9,08 $ contre 10,04 $, 62 contre 59, 17,4 contre 25,1 minutes. Opus 5.5 en effort max perd sur les trois tableaux, il n'y a donc aucune raison de l'utiliser.
- Là où Opus gagne : sous 3 $ par tâche. Opus en effort low et medium n'a pas d'équivalent Fable, et c'est là que se trouve l'essentiel du trafic en production.
- Là où Fable cesse d'être rentable : xhigh coûte 63 % de plus que high pour le même Intelligence Index (62). Anthropic donne le même conseil : démarrer Fable 5.2 en high et ne passer en xhigh que là où un gain a été mesuré.
Les chiffres de lancement d'Anthropic vont dans le même sens. Sur FrontierCode 2.0, Fable 5.2 en effort high obtient 45,3 %, au niveau du meilleur score d'Opus 5.5 (45,5 %), pour environ la moitié du coût par tâche. Sur Chartography, Fable en medium obtient 66,4 %, au-dessus d'Opus 5.5 en max (64,4 %), pour moins d'un dixième du coût. Sur Humanity's Last Exam, Fable en low égale le meilleur score d'Opus pour moins d'un dixième du coût.
Prenez les comparaisons à coût égal publiées par un éditeur comme un point de départ, pas comme une garantie. Les tâches sont choisies par Anthropic, et le coût par tâche d'Artificial Analysis est une moyenne sur sa propre suite d'évaluations. Vos tâches se comporteront différemment.
Le cache ne change pas le ratio
La lecture du cache coûte 0,20 $ par million de tokens sur les deux modèles, on pourrait donc croire qu'un long contexte en cache réduit l'écart. Ce n'est pas le cas, parce que ce sont les tokens de sortie qui font la facture. Exemple : une session d'agent qui lit 2M de tokens en entrée (90 % depuis le cache) et écrit 80K tokens.
| Poste | Opus 5.5 | Fable 5.2 |
|---|---|---|
| 1,8M de lectures du cache | 0,36 $ | 0,36 $ |
| 0,2M d'entrée hors cache | 0,80 $ | 1,60 $ |
| 80K de sortie (réflexion incluse) | 1,60 $ | 3,20 $ |
| Total | 2,76 $ | 5,16 $ |
La sortie représente 58 % de la facture Opus et 62 % de la facture Fable. Or c'est l'effort qui pilote les tokens de sortie et de réflexion. Voilà pourquoi Fable avec un effort plus bas peut coûter moins cher qu'Opus avec un effort plus haut. Si vous ne retenez qu'une chose : choisissez d'abord le niveau d'effort, ensuite le modèle.
Cas d'usage réels : quel modèle gagne
Les benchmarks ne servent que s'ils correspondent à un vrai travail. Pour chaque usage courant, voici le modèle et l'effort par lesquels nous commencerions, avec le chiffre qui justifie ce choix.
| Usage | Commencer avec | Pourquoi |
|---|---|---|
| Corrections de bugs, petites fonctionnalités, revues de PR | Opus 5.5, medium | La plupart des écarts en code sont de 1 à 4 points ; Opus medium (2,45 $/tâche) coûte moins que toute configuration Fable |
| Migration ou refactoring de plusieurs heures | Fable 5.2, high | FrontierSWE +7,6, Remote Labor Index presque x2 ; Fable high bat Opus max en coût et en temps |
| CI, infra, agents shell | Opus 5.5, medium ou high | Égalité sur Terminal-Bench 4.0 ; Opus génère environ 12 % plus vite en moyenne |
| Recherche sur PDF, graphiques, rapports | Fable 5.2, medium | Sur Chartography, medium bat Opus max pour moins d'1/10 du coût ; WANDR +9,8 |
| Scènes 3D, CAO, code géométrique | Fable 5.2, high | BenchCAD 2.1 est le plus gros écart de tous (+26,4 sans outils) |
| Interface à partir de captures ou maquettes | Fable 5.2, medium | SWE Multimodal +12,7 |
| Automatisation métier (CRM, e-mails, tableurs) | Fable 5.2, medium | AutomationBench +8,9 ; WANDR en medium égale le meilleur score d'Opus pour environ 40 % du coût |
| Rédaction client, documentation, présentations | Opus 5.5, medium | Préféré en face-à-face sur AA-Briefcase (Elo), pour moitié prix |
| Questions factuelles où une erreur coûte cher | Fable 5.2, low | AA-Omniscience 63 en low contre 48 pour Opus en max |
| Classification, extraction, sous-agents à gros volume | Aucun des deux : Sonnet 5.5 ou Haiku 5.5 | Opus low (0,98 $/tâche) est le plancher de ce comparatif ; les petits modèles descendent plus bas |
Le code au quotidien dans Claude Code
Pour les tickets, les petites fonctionnalités et la revue de code, Opus 5.5 reste le meilleur rapport qualité-prix.
Les benchmarks de code sont serrés, Opus gagne ProgramBench, et sur les forfaits Pro et les sièges Team standard,
Fable est limité à 50 % de l'usage hebdomadaire pendant la promotion de lancement. Une méthode qui marche bien :
rester sur Opus 5.5, et passer à Fable 5.2 avec
/model quand Opus a
échoué deux fois sur la même tâche, ou quand la tâche touche beaucoup de fichiers et prend des heures. Si vous
utilisez Claude dans un éditeur, notre guide pour
utiliser Claude avec
Cursor explique comment choisir le modèle.
Longues sessions d'agent et migrations
C'est le cas le plus clair en faveur de Fable 5.2. Le Remote Labor Index (de vraies missions de type freelance) double presque, de 21,3 % à 41,3 %. Les partenaires décrivent le même comportement au lancement : Uber explique qu'il "works until the job is actually complete instead of stopping at a plausible checkpoint", et Vercel "I haven't had to say 'No, I meant...' a single time." Sur une longue session, les relances et les corrections humaines coûtent bien plus que les tokens. Un modèle qui en demande moins revient moins cher, même avec un prix au token deux fois plus élevé.
3D : three.js, scripts Blender, CAO
La question "Fable 5.2 ou Opus 5.5 pour la 3D" revient souvent, et les données la tranchent : BenchCAD 2.1 montre le plus gros écart de tous les benchmarks (75,4 % contre 49,0 % sans outils, 83,5 % contre 65,3 % avec outils). Construire une géométrie à partir d'une description demande du raisonnement spatial, et c'est là que Fable 5.2 creuse le plus l'écart. Notre répartition : Fable 5.2 pour générer la première version d'une scène, d'un rig ou d'une pièce, puis Opus 5.5 pour les retouches bon marché (couleurs, mouvements de caméra, petits paramètres). La vidéo comparative de Peter Yang contient deux tests 3D (une vidéo de voyage à Kyoto codée de A à Z et un jeu de course de karts) et montre chaque prompt et chaque résultat. Regardez-la avant de décider. Il y signale aussi un test où Opus garde l'avantage.
Recherche, graphiques et analyse de documents
C'est le cas le plus rentable pour Fable 5.2, parce qu'il gagne dès l'effort medium. Sur Chartography, medium (66,4 %) bat Opus en max (64,4 %), la recherche agentique WANDR est à +9,8, et AA-Omniscience montre moins de faits inventés. Pour une due diligence, une étude de marché ou la lecture de nombreux rapports contradictoires, Fable medium est à la fois moins cher et plus fiable qu'Opus poussé au max. Exception : GDP.pdf, un benchmark sur documents où Opus fait un peu mieux. Testez donc vos propres charges de travail riches en PDF avant de basculer.
Rédaction et capacité à tenir sa position
Pour les articles, la documentation et les livrables clients, commencez par Opus 5.5 : ses textes sont légèrement
préférés en face-à-face, et il coûte deux fois moins cher. Aucun des deux modèles n'évite par défaut les tournures
génériques d'IA. Un court bloc de style dans
CLAUDE.md ou dans votre
prompt système (voix active, pas de mots de remplissage, pas de précautions oratoires, pas de flatterie) change
plus le résultat que le choix du modèle. La vidéo de Peter Yang teste aussi quel modèle tient sa position quand
l'utilisateur conteste, à regarder si vous utilisez Claude pour challenger vos décisions.
Sécurité et biologie
Fable 5.2 applique des classifieurs cyber et biologie. Quand une requête est bloquée, Anthropic fait répondre
Opus 4.8 pour la cyber et Opus 5 pour la biologie. Anthropic annonce environ 55 % de faux positifs en moins par
rapport à Fable 5.1. Les organisations vérifiées dans la cyber et les sciences du vivant peuvent demander
Claude Mythos 5.2, le même modèle proposé via les programmes de vérification d'Anthropic. Opus
5.5 a lui aussi des classifieurs cyber et bio, changer de modèle ne supprime donc pas les refus. Dans l'API, gérez
la raison d'arrêt
refusal sur les deux.
Router entre les deux dans l'API
Le guide officiel d'Anthropic conseille de démarrer avec Opus 5.5 et de passer à Fable 5.2 quand vos évaluations en xhigh ou max restent insuffisantes. En code, cela donne un petit routeur qui fixe le modèle et l'effort en même temps :
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic();

function route(task: { longRun: boolean; research: boolean; failedOnOpus: boolean }) {
  if (task.longRun || task.failedOnOpus) return { model: "claude-fable-5-2", effort: "high" } as const;
  if (task.research) return { model: "claude-fable-5-2", effort: "medium" } as const;
  return { model: "claude-opus-5-5", effort: "medium" } as const;
}

const { model, effort } = route({ longRun: false, research: true, failedOnOpus: false });

const response = await client.beta.messages.create({
  model,
  max_tokens: 16000,
  output_config: { effort },
  betas: ["server-side-fallback-2026-07-01"],
  fallbacks: "default",
  messages: [{ role: "user", content: "Compare les graphiques de chiffre d'affaires des trois rapports joints." }],
});

if (response.stop_reason === "refusal") console.warn(response.stop_details);
Fixez toujours effort
explicitement, puisque les valeurs par défaut diffèrent.
fallbacks: "default"
relance une requête refusée sur un modèle de secours choisi selon la catégorie du refus, pour qu'un blocage de
classifieur ne mette pas fin à la tâche. Avant de faire confiance au routeur, passez 20 à 50 de vos vraies tâches
dans les deux modèles et comparez le coût par tâche réussie.
Ce qui casse en passant d'Opus 5.5 à Fable 5.2
- Historique en ajout seul. Fable 5.2 contrôle les modifications d'historique sur tous les
comptes. Si votre harnais modifie
system,toolsou des messages précédents en cours de conversation, corrigez cela en premier. - Les blocs de réflexion sont liés au modèle. Changer de modèle au milieu d'une conversation fait perdre la réflexion précédente. Routez par tâche, pas par tour.
- Le pilotage d'ordinateur exige
computer_toolset_20260801sur les deux modèles ; l'anciencomputer_20251124renvoie une erreur 400 sur l'API Claude (Amazon Bedrock l'accepte encore). - Outil advisor : un exécutant Fable 5.2 n'accepte que Fable 5.2 ou Mythos 5.2 comme advisor.
- Inchangé par rapport à Opus 5.5 : pas de
budget_tokens, pas detool_choiceforcé (any/tool), pas de préremplissage de la réponse. - Conformité : Fable 5.2 exige une rétention des données de 30 jours. Les organisations en zero data retention reçoivent une erreur 400, sauf autorisation explicite d'Anthropic.
FAQ
Fable 5.2 est-il meilleur qu'Opus 5.5 ?
En capacités, oui : il gagne 20 benchmarks sur 24, et l'Intelligence Index d'Artificial Analysis est de 65 contre 59 en effort max. En rapport qualité-prix, tout dépend du budget. Au-delà d'environ 3 $ par tâche, Fable 5.2 donne plus d'intelligence par dollar. En dessous, Opus 5.5 en effort low ou medium n'a pas d'équivalent chez Fable.
Fable 5.2 vaut-il 2x le prix ?
Pour les longues sessions d'agent, la recherche, la CAO et la 3D, généralement oui. À effort comparable, il coûte souvent moins cher par tâche terminée qu'Opus 5.5 (Fable low à 3,10 $ bat Opus high à 3,46 $). Pour les petites tâches de code et la rédaction, généralement non.
Fable 5.2 ou Opus 5.5 pour coder ?
Fable 5.2 mène sur FrontierCode 2.0 (49,1 % contre 45,5 %), FrontierSWE v2 (69,9 % contre 62,3 %) et SWE-bench Pro (93,0 % contre 89,9 %). Opus 5.5 gagne ProgramBench, et les deux sont à égalité sur Terminal-Bench 4.0. Opus pour le quotidien, Fable pour les gros changements en plusieurs étapes.
Fable 5.2 est-il plus rapide qu'Opus 5.5 ?
Opus 5.5 génère ses tokens plus vite (103 à 115 tokens/s contre 87 à 103 chez Artificial Analysis). Mais à intelligence égale, Fable termine souvent avant : Fable low met 6,5 minutes par tâche contre 9,5 pour Opus high. Les deux proposent un fast mode à 2x le prix standard.
Peut-on utiliser Fable 5.2 avec l'abonnement Claude Pro ?
Oui. Fable 5.2 est disponible sur Pro, Max, Ultra, Team et Enterprise. Pendant la promotion de lancement, les forfaits Pro et les sièges Team standard peuvent utiliser Fable jusqu'à 50 % de leurs limites d'usage hebdomadaires. L'effort par défaut est medium dans les apps Claude et dans Claude Code.
Quelle différence entre Fable 5.2 et Mythos 5.2 ?
Même modèle, même prix. Mythos 5.2 est réservé aux organisations approuvées via les programmes de vérification Cyber ou Life Sciences d'Anthropic, pour des travaux de sécurité et de recherche que les protections de la version grand public bloqueraient.
Faut-il arrêter d'utiliser Opus 5.5 ?
Non. Anthropic recommande toujours Opus 5.5 comme point de départ pour la plupart des tâches de code et de travail intellectuel. Fable 5.2 est le modèle vers lequel on monte quand il le faut.
En résumé
Fable 5.2 est le modèle le plus fort : 20 benchmarks sur 24, avec ses plus grosses avances sur les longues sessions d'agent, la CAO, la robotique et les sciences, et beaucoup moins d'hallucinations. Opus 5.5 reste le meilleur choix par défaut pour le code au quotidien, les agents terminal, la rédaction et tout ce qui coûte moins de 3 $ par tâche. Ne les comparez pas à leurs efforts par défaut. Alignez d'abord l'effort, mesurez le coût par tâche réussie sur vos propres usages, et passez à Fable 5.2 quand Opus 5.5 atteint ses limites.